กักกันเครื่องที่ติด Ransomware อัตโนมัติ — แต่ต้องมีคนกดอนุมัติ
isolate เครื่องที่ติด ransomware เป็น action ที่ย้อนกลับยาก ดูวิธีให้ automation วิ่งไปจนสุดแล้วหยุดรอคนกดอนุมัติ พร้อมดูหน้าจอ approval gate ของ zcrSOAR
กักกันเครื่องที่ติด Ransomware อัตโนมัติ — แต่ต้องมีคนกดอนุมัติ
ตีสองครึ่ง ระบบเด้งแจ้งเตือนว่าเครื่องหนึ่งในฝ่ายบัญชีกำลังเขียนทับไฟล์รัวผิดปกติ shadow copy หายไปเฉยๆ แล้วมีการต่อออกไปหา IP ที่ไม่เคยคุยด้วยมาก่อน ทุกนาทีที่ผ่านไปคือไฟล์ที่ถูกเข้ารหัสเพิ่ม
คำถามมีข้อเดียว: ควรให้ระบบตัดเครื่องนั้นออกจากเครือข่ายเองเลยไหม โดยไม่ต้องรอใคร
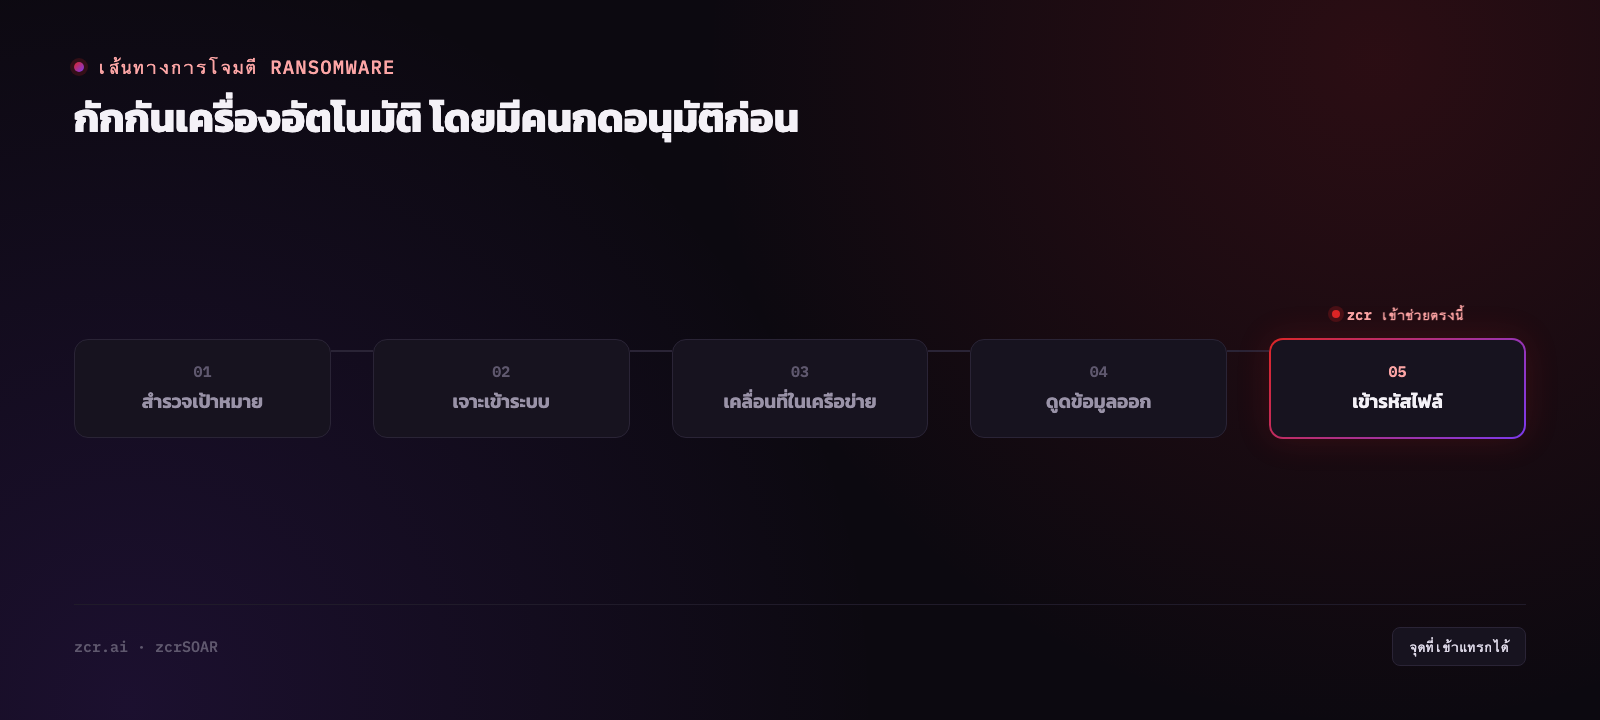
ทั้งสองฝั่งต่างก็มีเหตุผล
ทีมที่ตอบว่า "ตัดไปเลยสิ ไม่ต้องถาม" ไม่ได้คิดผิด ransomware สมัยนี้เข้ารหัสทั้งเครื่องได้ในเวลาไม่กี่นาที การรอคนตื่นมากดปุ่มตอนตีสามคือการยกเวลาให้ผู้โจมตีฟรีๆ และถ้าเครื่องนั้นมีสิทธิ์เข้าถึง file server ร่วม สิ่งที่เสียไม่ใช่แค่เครื่องเดียว
แต่ฝั่งที่ลังเลก็มีเหตุผลเหมือนกัน — และเป็นเหตุผลที่คนไม่ค่อยพูดถึงจนกว่าจะเคยโดนเอง
การ isolate เครื่องไม่ใช่ action ที่ "ลองแล้วไม่ใช่ก็กดกลับ" ได้แบบไร้ผลกระทบ ถ้าเครื่องที่โดนตัดคือเครื่องที่รันงานปิดงบสิ้นเดือนอยู่ หรือเป็น jump host ที่ทีมโรงงานใช้เข้าไปดูระบบควบคุม สิ่งที่ตามมาคือ downtime ที่คุณเป็นคนก่อเอง ไม่ใช่ผู้โจมตี แล้วเช้าวันรุ่งขึ้นก็จะมีคำถามจากฝั่งธุรกิจว่าใครอนุญาตให้ทำแบบนี้
ในองค์กรไทยหลายแห่ง ปัญหานี้หนักกว่าที่ควร เพราะ asset inventory ไม่ครบ ชื่อเครื่องในระบบ EDR กับชื่อที่ฝ่าย IT เรียกกันไม่ตรงกัน พอถึงเวลาจริงจึงไม่มีใครกล้าฟันธงว่าชื่อเครื่องนั้นคือเครื่องใคร ทำอะไรอยู่
เส้นแบ่งที่ใช้ได้จริง: ย้อนกลับได้ กับ ย้อนกลับยาก
แทนที่จะเถียงกันว่า "อัตโนมัติ" หรือ "แมนนวล" ลองเปลี่ยนคำถามเป็น: action นี้ถ้าทำผิด ย้อนกลับง่ายแค่ไหน
ย้อนกลับได้ ควรให้วิ่งอัตโนมัติทั้งหมด — ดึง process tree มาดู เช็ก hash กับรายการ IOC ที่มีอยู่ ดูว่าเครื่องนี้เพิ่งคุยกับใครบ้าง รวม log ที่เกี่ยวข้องไว้ในเคส ติด tag ความรุนแรง แจ้งเข้ากลุ่มทีม งานพวกนี้เป็นการอ่านและการรวบรวม ทำผิดก็แค่เสียแรงเครื่อง และเป็นงานที่คนทำช้ากว่าระบบหลายเท่า
ย้อนกลับยาก ควรมีคนกดอนุมัติ — ตัดเครื่องออกจากเครือข่าย ปิดบัญชี AD บล็อก IP ที่ขอบ kill process ที่กำลังรัน สี่อย่างนี้กระทบคนจริง งานจริง และบางอย่างกู้คืนไม่ได้ทันที
ส่วนที่ว่า playbook ที่มี node ประเภท Approval คั่นกลางหน้าตาเป็นยังไง agentic automation ใน SOAR เจาะไว้ครบแล้ว ตรงนี้จะไม่เล่าซ้ำ — ที่อยากคุยต่อคือสิ่งที่เกิดขึ้น หลัง จากคำขอนั้นถูกส่งออกไปแล้ว
พูดอีกแบบคือ ให้ automation วิ่งไปจนสุดทาง เตรียมทุกอย่างให้พร้อมกด แล้วหยุดรอหน้าประตู คนที่มาถึงไม่ต้องเริ่มสืบจากศูนย์ แค่ดูของที่ระบบเตรียมไว้แล้วตัดสินใจ — และประตูบานนั้นต้องเป็นของจริงที่บันทึกได้ว่าใครขอ ใช้สิทธิ์ระดับไหน และรอมานานแค่ไหน ซึ่งเป็นสิ่งที่ zcrSOAR มีให้เห็นบนหน้าจอ ไม่ใช่กติกาที่ตกลงกันปากเปล่า
ความต่างของสองแบบนี้อยู่ที่ "เวลาที่คนใช้ตัดสินใจ" ไม่ใช่ "จำนวน action ที่ทำอัตโนมัติ" ถ้า analyst เปิดเคสมาแล้วต้องไล่หาข้อมูลเองอีก 20 นาทีก่อนจะกล้ากดอะไร แปลว่า automation ยังหยุดเร็วเกินไป ไม่ใช่ช้าเกินไป
หน้าตาของ approval gate ตอนมันอยู่ในมือคนจริงๆ
หน้า Approvals & tasks ของ zcrSOAR รวมทุกอย่างที่กำลังรอคนตัดสินไว้ใต้แท็บแยกกัน ได้แก่ case approvals, playbook steps, revisions, response actions และ human tasks แท็บ Case approvals แสดงคำขออนุมัติระดับเคสที่ค้างอยู่เป็นการ์ดทีละใบ ตัว demo ใช้ข้อมูลตัวอย่าง จึงไม่ยกค่าที่เห็นบนหน้าจอมาอ้างในบทความนี้ สิ่งที่สำคัญคือการ์ดหนึ่งใบมีอะไรกำกับไว้บ้าง ลองอ่านให้ละเอียดสักใบ:
- ชื่อเคสและรหัสเคส พร้อมป้าย TRANSITION ที่บอกว่าคำขอนี้ต้องการเปลี่ยนสถานะเคสไปเป็นอะไร เช่น CONTAINED → CLOSED
- ข้อความบอกเหตุผลของคำขอ เช่น ขอปิดเคสหลังยืนยันแล้วว่ากักกันเสร็จ
- ใครเป็นคนขอ (
requested by) ค้างมานานแค่ไหน (waiting) เวลา SLA และสิทธิ์ที่คำขอต้องการ (REQUIRED: OPERATOR หรือ REQUIRED: ADMIN)
- ปุ่ม Reject วางอยู่ข้าง Approve บนการ์ดใบเดียวกัน คือ "ไม่อนุมัติ" เป็นทางเลือกปกติ ไม่ใช่ทางที่ต้องไปหาเอง
- บรรทัดเหนือรายการที่บอกว่าคนที่เปิดคิวอยู่ตัดสินคำขอในคิวนี้ได้หรือไม่
การ์ดของเคสคนละประเภทอาจต้องการสิทธิ์คนละระดับ แต่มานั่งรออยู่ในคิวเดียวกันได้ แปลว่า gate ตัวนี้ไม่ได้ผูกกับ ransomware โดยเฉพาะ ส่วนกติกาที่ว่าเคสแบบไหนต้องให้ใครตัดสินนั้นตั้งค่ากันตรงไหน หน้าจอนี้ไม่ได้แสดงไว้
สี่รายละเอียดบนการ์ดใบเดียวนี้ตอบคำถามที่ทีม security มักตอบไม่ได้เวลาถูกออดิทถาม:
- ใครเป็นคนขอ —
requested by ระบุตัวผู้ขอ ไม่ใช่ "ระบบทำ"
- คำขอนี้ต้องใช้สิทธิ์ระดับไหน —
REQUIRED: OPERATOR หรือ REQUIRED: ADMIN ติดอยู่บนใบคำขอเอง ส่วนคนที่กำลังนั่งดูคิวอยู่จะกดใบไหนได้บ้าง อยู่ในบรรทัดเหนือรายการอีกบรรทัดหนึ่ง พูดให้ตรงคือการ์ดบันทึก "สิทธิ์ที่คำขอต้องการ" ส่วนระบบเป็นคนเทียบว่าคนที่ถืออยู่ตอนนี้ทำอะไรได้
- ค้างมานานแค่ไหน —
waiting โผล่ให้เห็นบนหน้าจอเลย ไม่ต้องไปขุด log
- เหลือเวลาอีกเท่าไหร่ — ตัวเลข SLA คือเวลาที่เหลือก่อนเลยกำหนด ไม่ใช่เวลาที่ผ่านไปแล้ว ยิ่งคำขอค้างนาน ตัวเลขนี้ก็ยิ่งน้อยลง
ข้อ 3 กับ 4 คือจุดที่ระบบอนุมัติส่วนใหญ่พังเงียบๆ — ไม่ใช่เพราะไม่มี gate แต่เพราะ gate กลายเป็นที่ที่งานไปกองแล้วไม่มีใครรู้ว่ากองอยู่ ใครที่เคยเห็นคำขออนุมัติค้างในอีเมลใครสักคนสามวันแล้วไม่มีใครทัก น่าจะนึกภาพออก
ขอพูดตรงๆ ว่าหน้าจอนี้ยังตอบอะไรไม่ได้บ้าง
หัวข้อของแท็บนี้เขียนกำกับไว้เองเลยว่าเป็น "Case-level state-transition approvals — distinct from playbook-step approvals" คือเป็นการอนุมัติ การเปลี่ยนสถานะของเคส เช่น ขอปิดเคสหลังยืนยันแล้วว่ากักกันเสร็จ ไม่ใช่การขออนุมัติ "สั่ง isolate" ตอนนั้น
gate ของตัว action เองเป็นการอนุมัติอีกชนิดหนึ่ง และมีแท็บของตัวเอง แท็บ Playbook steps แสดงเป็นจุดให้คนตัดสินใจก่อนที่ automation ซึ่งหยุดรออยู่จะเดินต่อ กดอนุมัติแล้วรันที่หยุดไว้จะเดินต่อ กดปฏิเสธแล้วรันนั้นจะถูกยุติ และหน้าจอเตือนให้ตัดสินหลังตรวจหลักฐานแล้วเท่านั้น บทความนี้ไม่ได้ลงลึกเรื่องแท็บนั้น จึงไม่มีอะไรจะเล่าเพิ่มว่าคำขอเหล่านั้นถูกส่งไปหาใคร และใครตัดสินได้บ้าง
และอีกเรื่องที่หน้าจอนี้ไม่ได้บอก: พอ SLA หมดเวลา แล้วยังไงต่อ — escalate ให้คนถัดไป ปล่อยค้าง หรืออนุมัติเอง ภาพนี้ตอบไม่ได้ ถ้าจะเอาไปใช้จริงต้องถามให้ชัดก่อน เพราะพฤติกรรมตรงนี้คือความต่างระหว่าง gate ที่ปลอดภัยกับ gate ที่แค่ทำให้ทุกอย่างช้าลง
สัญญาณว่าเรื่องนี้ใช้กับองค์กรคุณ
- มี EDR ที่สั่ง isolate ได้ แต่ไม่มีใครกล้าเปิดโหมดอัตโนมัติ เพราะกลัวตัดผิดเครื่อง
- เคยมีเหตุการณ์ที่ตัดสินใจกักกันช้า เพราะรอคนที่มีสิทธิ์ตื่นมาตอบ
- ตอบไม่ได้ว่าครั้งล่าสุดที่กักกันเครื่อง ใครเป็นคนอนุมัติ และอนุมัติตอนกี่โมง
- คำขออนุมัติอยู่ในไลน์กลุ่มหรืออีเมล ไม่ได้อยู่ในระบบที่มีเวลาและตัวตนกำกับ
- มีเครื่องกลุ่มหนึ่งที่ "ห้ามตัดเด็ดขาด" แต่กติกานั้นอยู่ในหัวคน ไม่ได้อยู่ในระบบ
เข้าข่ายสองข้อขึ้นไป ปัญหาของคุณไม่ใช่ automation ไม่พอ แต่เป็นการตัดสินใจที่ยังไม่มีที่อยู่เป็นหลักแหล่ง
เทียบสามแนวทางแบบตรงไปตรงมา
| แนวทาง | เหมาะกับ | ราคาที่ต้องจ่าย |
|---|
| อัตโนมัติเต็มรูปแบบ | องค์กรที่ asset inventory แม่น รู้ชัดว่าเครื่องไหนตัดได้ | ตัดผิดเครื่องหนึ่งครั้งก็พอทำให้ฝ่ายธุรกิจสั่งปิดระบบอัตโนมัติทั้งหมด |
| อัตโนมัติจนถึง gate แล้วให้คนกด | องค์กรส่วนใหญ่ที่มีทีมเล็กแต่มีระบบสำคัญที่ห้ามพลาด | ยังเสียเวลาเท่ากับที่คนใช้ตัดสินใจ ต้องมีคนพร้อมรับจริง |
| แมนนวลทั้งหมด | องค์กรที่เพิ่งเริ่ม ยังไม่มีอะไรเชื่อมกัน | ช้าที่สุด และมักไม่เหลือหลักฐานว่าใครทำอะไรตอนไหน |
ไม่มีแบบไหนถูกสำหรับทุกองค์กร แต่แบบกลางมักเป็นจุดเริ่มที่เสียหายน้อยที่สุดถ้าคิดผิด — ดูแพ็กเกจ zcrSOAR ประกอบได้ว่าขนาดทีมแบบไหนคุ้มกับการทำ workflow นี้
อ่านต่อ
ก่อนจะมีเคสมากองในคิวอนุมัติ ต้องตรวจจับให้ได้ก่อน — ดูวิธี ตรวจจับ ransomware ด้วย SIEM ว่าสัญญาณอะไรที่ควรจับ และถ้าอยากเห็นว่าเคสหนึ่งเคสประกอบร่างจากเหตุการณ์ย่อยๆ ยังไง ลองอ่าน การอ่าน attack flow ตาม MITRE ATT&CK ส่วนใครที่ยังไม่แน่ใจว่า SOAR ต่างจาก SIEM ตรงไหน เริ่มที่ SOAR คืออะไร ก่อนได้
ติดต่อทีมงาน
อยากรู้ว่า workflow กักกันของทีมคุณควรตัดตรงไหนให้อัตโนมัติ และตรงไหนควรมีคนกด คุยกับทีมเราได้ฟรี ไม่มีค่าใช้จ่าย
แหล่งข้อมูลอ้างอิง
- Splunk SURGe — Gone in 52 Seconds…and 42 Minutes: A Comparative Analysis of Ransomware Encryption Speed — ทดสอบ ransomware 10 ตระกูลจริง พบตัวที่เร็วที่สุด (LockBit) เข้ารหัสไฟล์เกือบ 100,000 ไฟล์เสร็จภายใน 4 นาที 9 วินาที ยืนยันว่า ransomware "เข้ารหัสได้ในเวลาไม่กี่นาที" ตามที่บทความระบุ
- MITRE ATT&CK — T1490 Inhibit System Recovery — คำอธิบาย Technique การลบ shadow copy ที่กล่าวถึงในตอนต้นบทความ