4 ประเภทเหตุการณ์ OT — และวิธีอ่านว่าเรื่องไหนต้องรีบ
เหตุการณ์ OT ที่เจอบ่อย 4 แบบ ตั้งแต่ remote maintenance นอกเวลาถึง cloud egress ที่เบี่ยงเบน ดูว่าแต่ละแบบบอกอะไร และทำไมบางเรื่องที่ดูเบากลับต้องรีบก่อน
4 ประเภทเหตุการณ์ OT — และวิธีอ่านว่าเรื่องไหนต้องรีบ
เวลาพูดถึงการโจมตีระบบ OT คนมักนึกถึงภาพใหญ่แบบ Stuxnet หรือมัลแวร์ที่ทำให้โรงไฟฟ้าดับ แต่เหตุการณ์ที่ทีมดูแล OT เจอในชีวิตประจำวันจริงๆ หน้าตาไม่ได้ดราม่าขนาดนั้น และหลายครั้งก็ไม่ใช่การโจมตีด้วยซ้ำ
บทความนี้พาดูเหตุการณ์ OT 4 ประเภท แล้วแยกให้เห็นว่าแต่ละแบบบอกอะไร และทำไมบางเรื่องที่ดูเบากลับต้องรีบกว่าเรื่องที่ดูหนัก
เหตุการณ์ 4 ประเภท และแต่ละแบบมักต้องรีบแค่ไหน
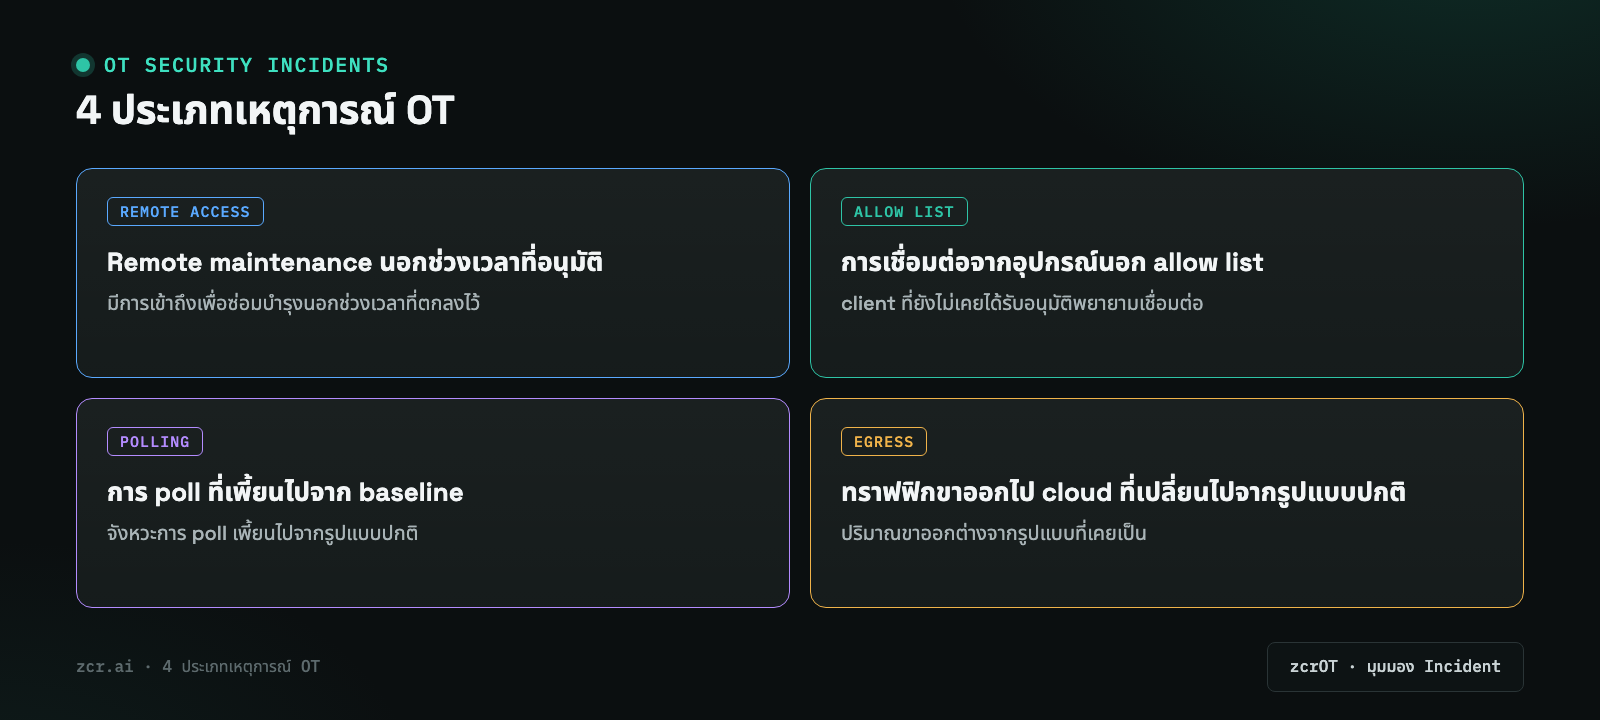
1. Remote maintenance นอกช่วงเวลาที่อนุมัติ
เหตุการณ์แบบนี้ทีมส่วนใหญ่มักถือว่าต้องรีบ เพราะเป็นการเข้าถึงเพื่อซ่อมบำรุงนอกช่วงเวลาที่อนุมัติไว้ ซึ่งอาจเป็นได้สองแบบ — ผู้รับเหมาที่มีสิทธิ์จริงแต่เข้ามานอกเวลาโดยไม่แจ้ง หรือคนอื่นที่ใช้ช่องทาง remote access ของผู้รับเหมา
ที่มันน่ากลัวคือช่องทาง remote maintenance มักเป็นทางเข้าที่ถูกต้องตามระบบ มีสิทธิ์เต็ม และมักไม่ได้ถูกจับตาเท่าทางเข้าอื่น พูดง่ายๆ คือถ้าจะมีทางเข้าไหนที่ผู้โจมตีอยากได้ที่สุด ก็ทางนี้แหละ
2. การเชื่อมต่อจากอุปกรณ์นอก allow list
คือกรณีที่มี client ซึ่งไม่อยู่ใน allow list พยายามเชื่อมต่อเข้ามาที่ gateway ในทางปฏิบัติ สาเหตุที่พบบ่อยที่สุดไม่ใช่แฮกเกอร์ แต่คืออุปกรณ์ใหม่ที่ฝ่ายวิศวกรรมเอามาต่อโดยไม่ได้แจ้ง IT หรือโน้ตบุ๊กของช่างที่เสียบเข้าเครือข่าย OT ตรงๆ
แต่หลายทีมก็ยังมองว่าต้องรีบ เพราะจากมุมของระบบ มันแยกไม่ออกว่าอุปกรณ์ที่ไม่รู้จักตัวนี้คือช่างหรือคือคนอื่น จนกว่าจะมีคนไปตรวจสอบ
3. การ poll ที่เพี้ยนไปจาก baseline
จังหวะการ poll ที่เพี้ยนไปจาก baseline ปกติ กรณีนี้ส่วนใหญ่เป็นปัญหาทางเทคนิคมากกว่าความปลอดภัย เช่น อุปกรณ์เริ่มมีปัญหา สายสัญญาณเสื่อม หรือเครือข่ายหนาแน่นผิดปกติ
ทีมส่วนใหญ่จึงมักไม่ได้ถือว่าเป็นเรื่องด่วนมากนัก แต่มันก็คุ้มที่จะดู เพราะการ poll ที่ผิดจังหวะอาจเป็นสัญญาณแรกว่ามีอะไรบางอย่างกำลังแทรกอยู่ระหว่างทาง และในบางกรณีก็เป็นสัญญาณเตือนล่วงหน้าว่าอุปกรณ์กำลังจะพัง ซึ่งก็มีค่าในตัวมันเอง
4. ทราฟฟิกขาออกไป cloud ที่เปลี่ยนไปจากรูปแบบปกติ
ปริมาณ egress ที่ต่างไปจากรูปแบบเดิม ในโรงงานที่มีระบบส่งข้อมูลขึ้น cloud เป็นปกติ การเปลี่ยนแปลงของปริมาณอาจมาจากการอัปเดตซอฟต์แวร์ การเพิ่ม sensor หรือในกรณีที่แย่กว่านั้นคือมีข้อมูลถูกส่งออกไปที่ที่ไม่ควรส่ง
เรื่องนี้ทีมมักไม่ได้ถือว่าด่วนมากนักเช่นกัน
วิธีอ่านที่ควรรู้: Risk Score ไม่ใช่ลำดับความเร่งด่วนเสมอไป
incident ส่วนใหญ่มี risk score กำกับ เลยอดไม่ได้ที่จะไล่ทำจากคะแนนสูงสุดลงมา แต่ลองนึกภาพว่าเคสที่คะแนนสูงสุดมีสถานะ ACK (มีคนรับเรื่องแล้ว) ในขณะที่เคสคะแนนต่ำกว่ายังเป็น Open
สถานการณ์แบบนี้ไม่ใช่ความผิดพลาด แต่สะท้อนว่าในการทำงานจริง ทีมจะจัดลำดับจากหลายปัจจัย ไม่ใช่แค่ตัวเลข risk อย่างเดียว — เคสที่มีคนรับเรื่องแล้วอาจกำลังรอข้อมูลจากผู้รับเหมาสักราย ส่วนเคสที่ยัง Open อาจเพิ่งเข้ามา
ประเด็นคือ risk score ช่วยจัดลำดับ ไม่ได้ตัดสินแทน ถ้าทีมไล่ตามตัวเลขอย่างเดียวโดยไม่ดูบริบท ก็จะพลาดเรื่องที่ตัวเลขต่ำแต่จริงๆ สำคัญ เช่น cloud egress ที่เบี่ยงเบนเพียงเล็กน้อยแต่เกิดขึ้นทุกคืนติดกันเป็นสัปดาห์
สิ่งที่ทั้ง 4 แบบมีร่วมกัน
ลองสังเกตดูจะเห็นว่าไม่มีเคสไหนเลยที่เป็น "มัลแวร์ถูกตรวจพบ" แบบที่เห็นในโฆษณาผลิตภัณฑ์ security ทุกเคสคือความเบี่ยงเบนจากสิ่งที่เคยเป็นปกติ
นี่คือหัวใจของการทำ OT security — เพราะระบบ OT มีลักษณะที่ทำงานซ้ำๆ เหมือนเดิมทุกวัน ซึ่งต่างจากเครือข่าย IT ที่พฤติกรรมผู้ใช้เปลี่ยนตลอด ความสม่ำเสมอนี้กลายเป็นข้อได้เปรียบ เพราะอะไรที่ผิดไปจากเดิมจะเห็นชัดกว่ามาก
อ่านต่อว่ากระบวนการกรองที่คัดทุกอย่างให้เหลือเป็น incident แบบนี้ทำงานยังไงได้ที่ Deterministic Detection Rules ใน OT ทำงานยังไง และดูภาพรวมว่าทำไม OT ต้องมีวิธีคิดของตัวเองที่ OT Security สำหรับโรงงานอุตสาหกรรม
zcrOT จัดการ Incident แบบนี้ให้
zcrOT มีหน้า Incidents ที่รวม match ที่เกี่ยวข้องกันเป็นเคสเดียว พร้อม risk score, severity, สถานะ (เช่น Open, ACK หรือ Closed) และรหัสอ้างอิงที่ตามย้อนกลับไปดูหลักฐานระดับ event ได้
ถ้าอยากเห็นว่าหน้า Incidents ทำงานยังไง ลองเปิด zcrOT demo ดูได้เลย ส่วนถ้าอยากรู้ว่าเครือข่าย OT ของคุณจะมี incident แบบไหนโผล่มาบ้าง ติดต่อทีมงานด้านล่าง หรือดู แพ็กเกจ zcrOT
ติดต่อทีมงาน
อยากให้ช่วยดูว่าเหตุการณ์แบบไหนที่ควรตั้งเป็น Critical สำหรับโรงงานคุณ คุยกับทีมเราได้ฟรี ไม่มีค่าใช้จ่าย